档案№002日期字数约 6,600
从零训练一个 chunk interleaved 全双工语音模型
把一个按话轮问答的语音大模型改成 1 秒一拍、边听边说、还能调工具的全双工模型:协议、四阶段课程、数据合成,以及一路踩过的坑。
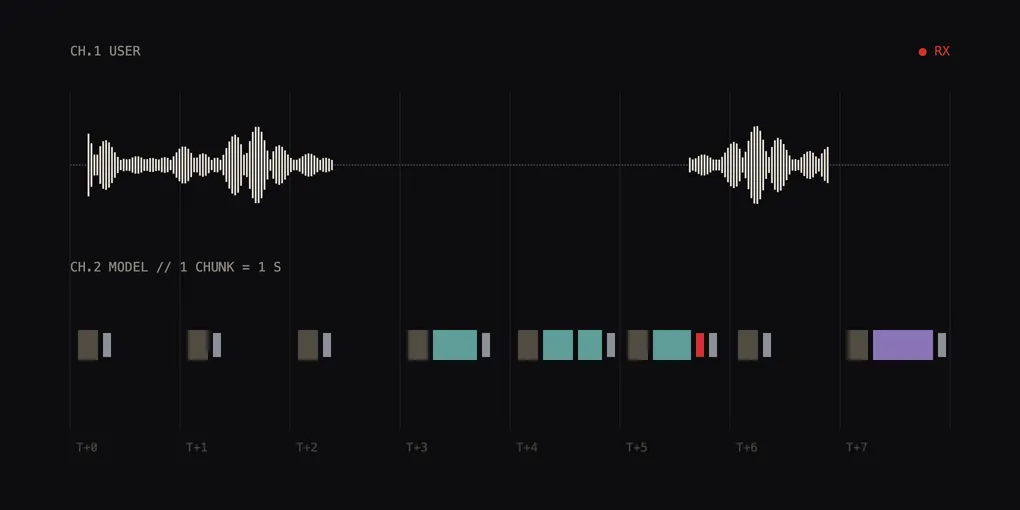
过去几个月我在做一件事:把一个「你说完我再说」的语音大模型,改造成能边听边说的全双工模型。它以 1 秒为一拍,每一拍听一秒用户的声音,自己决定这一秒是继续听、开口说话,还是发一个工具调用让后台 agent 去干活。
论文暂时不投了,但过程里有不少东西值得记下来。这篇按时间顺序讲:从选骨干开始,每一步模型缺什么、我们怎么补、补完的数字是多少。文末有一份清单,给想自己做一遍的人。
两条路线:并行流和 chunk interleaved
全双工模型目前大致两类做法。
并行流,代表是 Moshi:用户和助手各占一条流,按 80 ms 一帧同步往前走。好处是时间分辨率高,代价是要专门的多流结构,想在里面再塞进打字输入、后台通知、工具调用就很别扭。
chunk interleaved(也叫时分复用),代表是 OmniFlatten、MiniCPM-o 4.5:把时间切成固定长度的块(这里是 1 秒),每一块先放这一秒「进来」的东西,再放模型这一秒「出去」的东西,全部排进同一条因果序列。骨干就是一个普通的自回归语言模型,一行结构都不用改。也正因为是一条普通序列,用户打的字、后台任务进度、工具调用都能自然地放进去。
我选的是后者。它的诱人之处在于:手里已经有很强的回合制语音模型了,理论上「换个序列格式再训一训」就能变成全双工。这篇的主题其实就是:这个「训一训」到底要补哪些东西。
起点:骨干和耳朵
- 大脑:Qwen2.5-Omni-7B 的 Thinker,只用它的文本语言模型部分(hidden size 3584)。
- 耳朵:Qwen3-ASR-1.7B 的音频编码器 AuT(输出 2048 维)。
- 接线:一个新建的线性层
perception.proj,把 2048 维投到 3584 维。
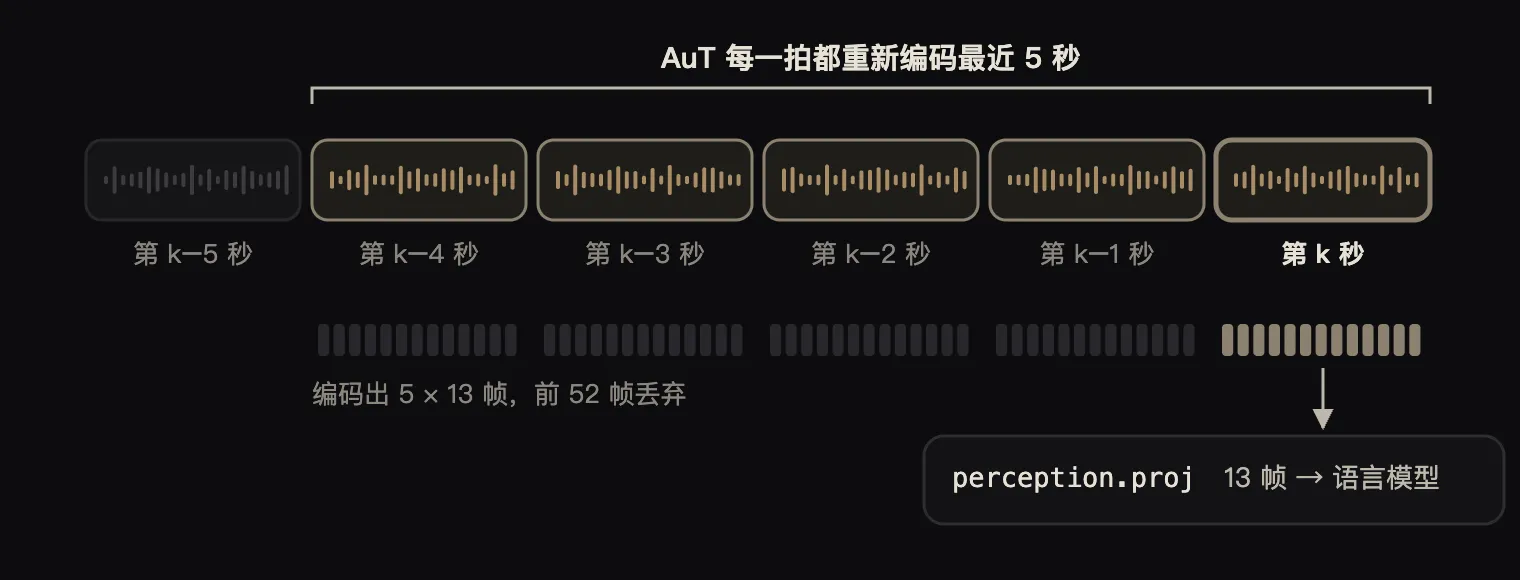
音频是 16 kHz 单声道,AuT 的帧率是 80 ms 一帧(12.5 Hz),所以一秒对应 13 个音频 token。
有个细节:不要把每一秒单独拿去编码。单独编码一秒钟的音频,边界上的表示很差。我们的做法是每一拍都对「最近 5 秒」做一次编码(滑动窗口),然后只把属于当前这一秒的 13 帧切出来送进语言模型。代价是重复计算,换来的是每一秒的表示都看得到足够的上文。
协议:一个 token 同时管「在听」和「这一秒说完了」
在 Qwen 原有的 151,665 个词表之外,加三个控制 token:
| token | 含义 |
|---|---|
<|bos|> |
话轮开始 |
<|turn_eos|> |
这一轮说完了 |
<|chunk_eos|> |
这一秒的输出到此为止 |
这几个 token 的 embedding 和输出头放在一张独立的可训练小表里,原来的大词表矩阵保持冻结。
每一秒的序列长这样(示意):
… [这一秒的 13 个音频 token] [可选:这一秒的文本事件] → 模型输出 … <|chunk_eos|>模型这一秒如果选择不说话,就直接输出 <|chunk_eos|>,只需要一次前向;如果要说,就先吐出这一秒的文字(说完一轮再跟一个 <|turn_eos|>),最后以 <|chunk_eos|> 收尾。连续几秒放在一起:
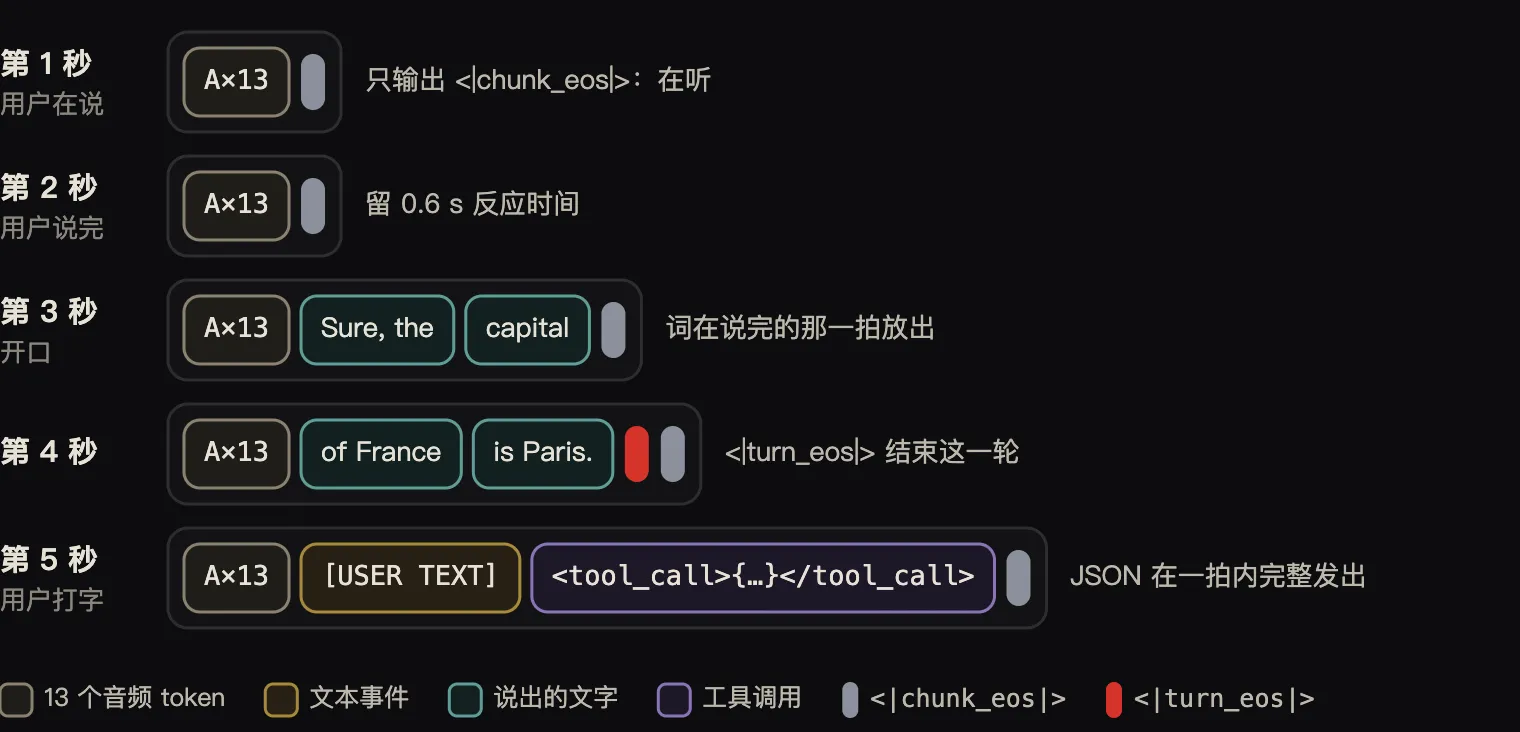
MiniCPM-o 和一些同类工作会在每一块开头放一个专门的 [listen] / [speak] 二选一 token。我们省掉了它:「听」就是「第一个 token 就是 <|chunk_eos|>」。这样协议里只有一个和时钟相关的 token,模型要学的决策也只有一个:这一秒什么时候停。
推理时,每秒的说话文本限制在 8 个 token 以内(防止一秒里说出十秒的话);工具调用例外,最多 512 个 token,保证一段 JSON 在同一拍里完整发出。
文字什么时候放出来
训练数据里每个词都有强制对齐得到的起止时间。最直接、也最符合因果的规则是:一个词在它说完的那一秒才放出来(word-end release)。写成公式就是:
词 w 放在第 k 拍:k(w) = max(1, ceil((t_end(w) - τ_lead) / 1s))τ_lead 一开始是 0。后来为了让下游 TTS 早一点拿到文字,改成了 0.4 s(原因见后面 Talker 一节)。<|turn_eos|> 放在这一轮结束的那一拍;用户说完到助手开口之间留 0.6 s 的反应时间。
loss 要按全局 token 数归一化
流式序列里,「听」的那一拍只有 1 个监督 token,工具调用那一拍可能有几十个。多卡训练时各卡分到的有效 token 数差别很大,如果每张卡先各自求平均,梯度就会偏向 token 少的那张卡。
做法是:每张卡上的 loss 加权求和后,除以所有卡的有效 token 总数,再乘以卡数抵消 DDP 的平均。这样多卡的梯度和「单进程一次跑完整个 batch」完全一致(我们在 4 张 A800 上核对过,相对误差 2.45×10⁻¹¹)。token 权重是:<|bos|>、<|turn_eos|>、工具调用 5.0,<|chunk_eos|> 和普通文字 1.0。
四阶段课程
直接拿回合制模型去训交错的流式对话,投影层和话轮控制都会一起乱掉。所以分阶段走:
| 阶段 | 序列模式 | 训练什么 | 数据 | 步数 / 峰值学习率 |
|---|---|---|---|---|
| Stage 1 | 离线 | 只训 perception.proj + 3 个控制行(7.35M 参数),不上 LoRA |
英文 ASR | 20,000 / 1e-4 |
| Stage 2 | 离线 | + LLM LoRA(r=16, α=32) | 243 万条口语问答 + ASR | 48,001 / 2e-5 |
| Stage 3 | 1 s 流式 | 合并 Stage 2,装新 LoRA,解冻控制 embedding | ASR + 问答 | 130,000 / 2e-5 |
| Stage 4 | 1 s 流式 | 全双工对话、工具调用,最后转全参数训练 | 合成双工会话 + 委托会话 + ASR | 见下文 |
「离线」指的是 提示 → 整段音频 → 完整答案 → <|turn_eos|>,也就是普通回合制的格式。
Stage 1 只是把耳朵接上。刚初始化时模型根本不会停,64 条测试里 61 条一直生成到上限,WER 超过 1000%;只训投影层和 3 个控制行之后,截断全部消失,LibriSpeech test-clean 降到 3.49%(这组数字来自我们在 4 卡上做的完整复现)。
Stage 2 在离线格式下教它回答问题。注意答案的音频只用来提取词的时间戳,模型的输入始终只有用户音频。
坑一:模型不知道「一秒」在哪里结束
Stage 2 训完,离线模式下 LibriSpeech test-clean 的 WER 是 2.99%。同一份权重,什么都不改,只是把音频改成一秒一秒地喂、要求它每一秒都停一次,WER 变成了 140%(四个测试集上 123%–180%)。
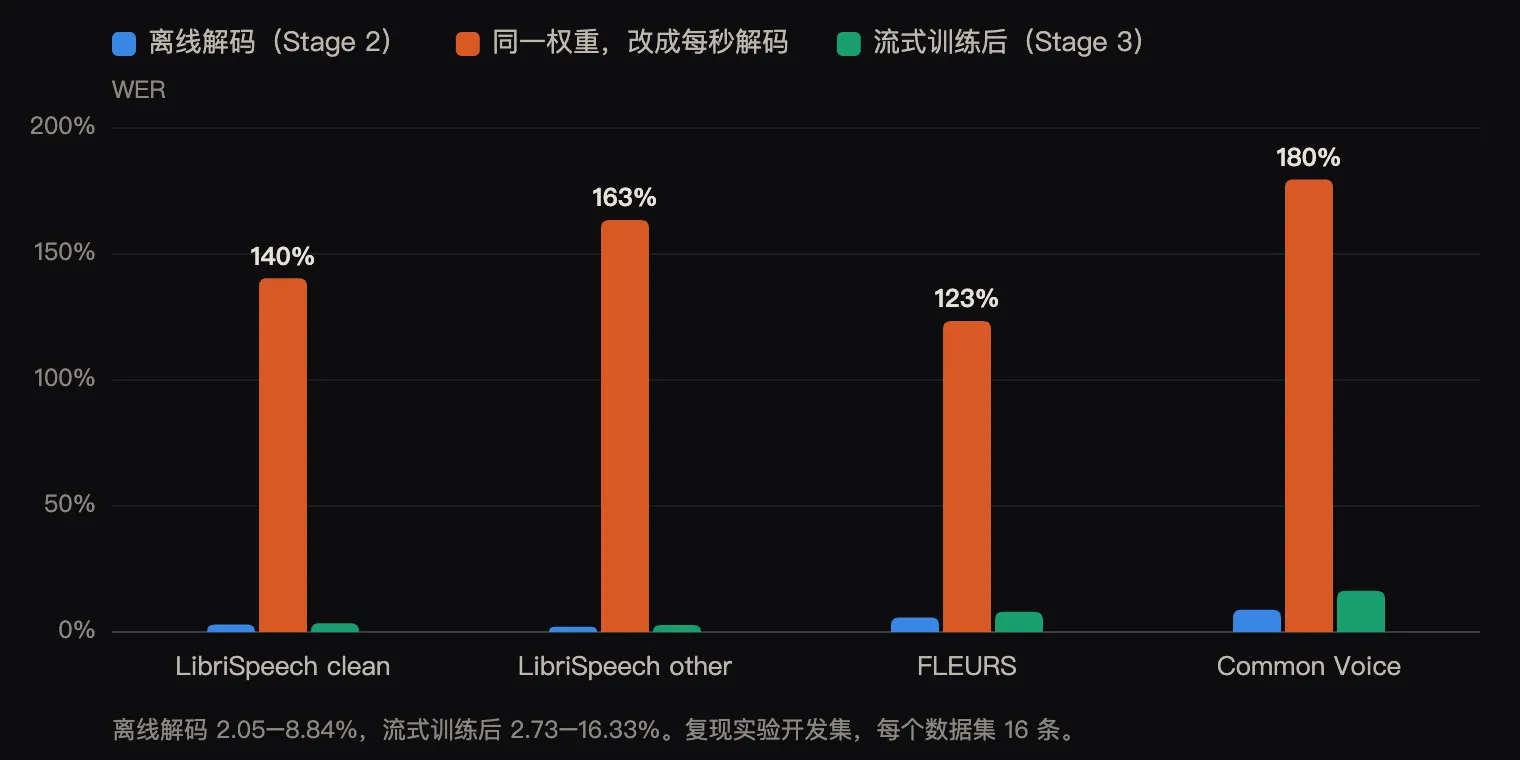
原因很简单:离线训练里从来没有出现过「一秒的边界」,模型没有任何关于什么时候该在一拍里收手的先验,只会在每一拍里拼命往外吐字。
这就是 Stage 3 存在的意义:切换到 1 秒交错的流式格式,让模型在每个安静的拍子上学会输出 <|chunk_eos|>,并且学会把要说的话按因果顺序分摊到各个拍子里。
结果出乎意料地好:Stage 3 的流式模型在四个 ASR 测试集(共 22,599 条)上的综合 WER 是 10.48%,反而低于离线前身的 10.72%(LibriSpeech test-clean 2.71%)。差距主要来自 FLEURS 的长句:离线自回归解码偶尔会陷进重复插入的死循环(WER 20.62%),而 1 秒一拍的结构天然把每一拍的生成限制在这一秒听到的范围内。
流式也有代价:知识类问答掉了一些,Llama Questions 从 78.2% 掉到 70.1%,TriviaQA 从 56.9% 掉到 53.0%。
全双工数据:为什么拼接对话不够
Stage 3 只见过单轮问答。在复现实验里,拿它跑多轮双工会话,「该说话的拍子」只有 51.8% 说对了。所以 Stage 4 要喂真正的双工对话。
问题是:带精确时间标注、带重叠和打断的真实双声道对话几乎没有。通行做法(参考 OmniFlatten)是拼接:把单轮问答 TTS 出来,拼成双声道会话,覆盖三种时序:
- 正常接话:用户说完 0.6 s 后助手开口;
- 用户打断:助手回复播出至少 25% 后,用户在截断点前 0.6 s 插话;
- 说完以后等待;
再给一半的用户音轨加 15–30 dB 的 MUSAN 噪声。
拼接数据确实有效:复现里「该说话的拍子」从 51.8% 涨到 85.5%。在 Full-Duplex-Bench 上,这个模型的综合分是 0.953,高于 MiniCPM-o 4.5 的 0.863;真打断时 98.5% 都能停下来回应。
坑二:它学会的其实是一条「声音检测」规则
但 Full-Duplex-Bench v1.5 的干扰项一测就露馅了:用户转头跟旁边的人说话,它 97% 的情况会接话回答;背景里有人声,96% 会回答。
回头看数据就明白了:TTS 合成的单轮问题里,句子中间几乎没有超过 0.3 s 的停顿(p90 只有 0.24–0.29 s)。在这样的数据里,下面这条规则从来不会被违反:
安静超过 0.6 s 就接话;助手说话时只要有人出声,就停下来回答。
模型学到的就是这条规则,跟话是谁说的、对谁说的没有关系。
于是我们重新合成了一份多条件双工数据:343,763 个训练会话,共 7,991 小时,中英文都有。在拼接的基础上叠加四种情况:
- 句中犹豫停顿:用强制对齐找到句法上会犹豫的位置(虚词后、逗号处、前提和问题之间),插入 0.3–3.0 s 的对数正态停顿(至少 40% 跨过一整拍),填上低电平的房间底噪并做交叉淡化;还有带「um / uh / let me think」的变体。停顿期间只监督
<|chunk_eos|>。 - 用户附和与背景人声:助手说话时,在用户音轨叠加「yeah」「mm-hmm」「right」或背景人声,监督助手继续把话说完。
- 旁人插话,先停后续:用户说着说着转头跟别人讲话,监督助手先停下,等旁人的话说完再把没讲完的内容接着讲。
- 助手附和:用户一段话超过 6 秒时,在合适的词间空隙插入助手简短的「嗯」「对」。
用这份数据继续训练后,Full-Duplex-Bench 上的变化:
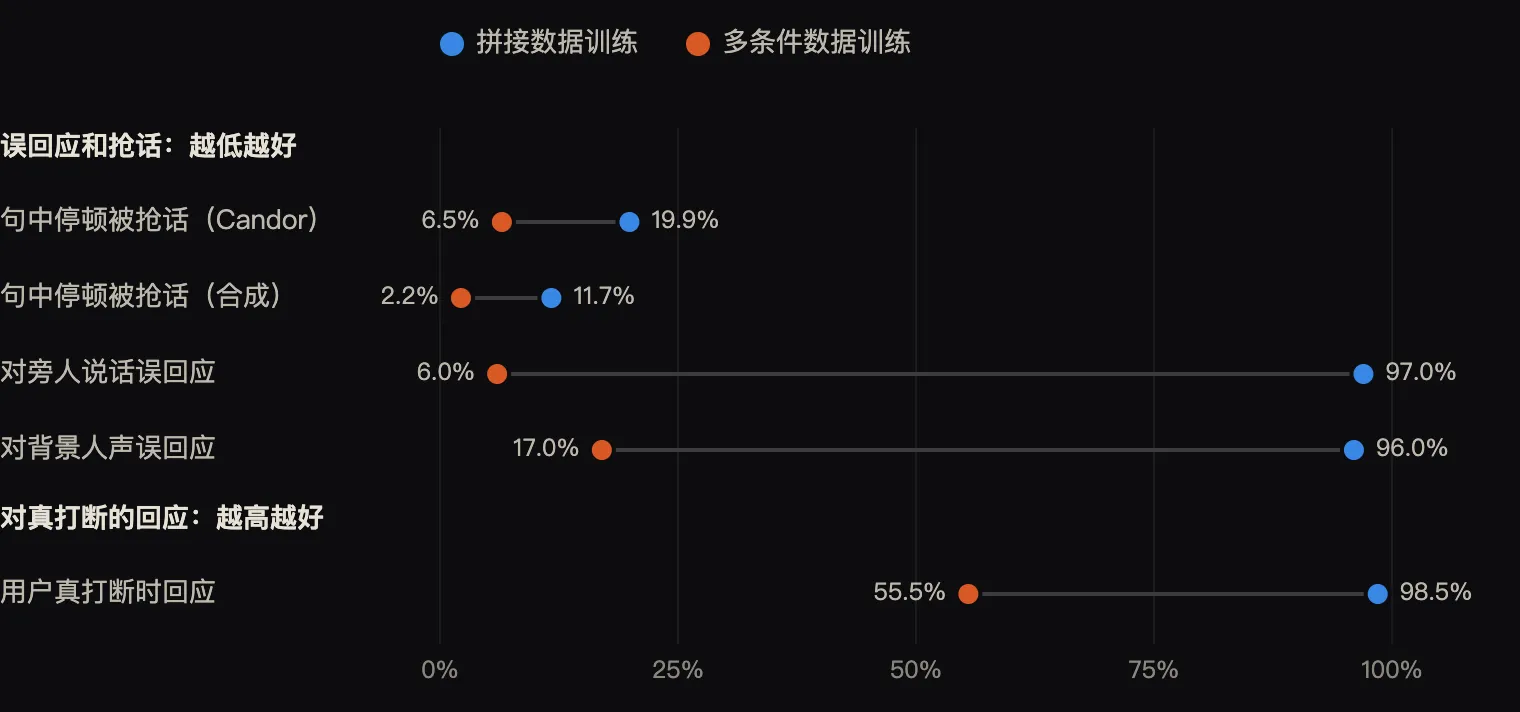
最后一行是代价。FDB v1.5 把模型分成两类:responsive(有重叠就让,真打断处理得好,但会被无关的声音带跑)和 floor-holding(不轻易让出话轮,抗干扰,但响应真打断会慢)。我们从前者走到了后者。在不认识用户声音的前提下,这本质上是灵敏度和特异度的取舍,没有白给的午餐。
还有一个小坑:只用双工数据训、不混 ASR 数据,复现里 Common Voice 的 WER 从 16.3% 涨到 32.7%,不该说话时开口的拍子也变多了。所以后面的数据配方里一直混着 ASR 和问答。
工具调用:死掉的 embedding 行
我们还想让模型在对话中把活儿派给后台 agent(比如写代码、跑测试)。协议上:
- 每一拍的 13 个音频 token 之后,可以附上这一秒发生的文本事件:用户打的字、正在输入的提示、后台任务的进度和结果;
- 模型通过两个工具行动,都包在
<tool_call>…</tool_call>里:delegate{text, kind}(kind是新任务 / 中途修改 / 取消)和memory{op, text}。
坑三:验证 loss 很低,但一次都没调用过
第一版在冻结 embedding 的前提下用 LoRA 训练。验证集 teacher-forced loss 是 0.656,看起来很健康。但自由生成一测:258 个会话、506 次该调用的时机,一次工具调用都没发出。
查 Qwen2.5-Omni-7B Thinker 的词表才发现:<tool_call>(ID 151657)和 </tool_call>(ID 151658)在预训练里从来没被训练过,输入 embedding 的范数是 0.000,跟没用过的 padding 行一模一样(正常 token 的平均范数是 0.771)。embedding 冻住、LoRA 只动注意力和 MLP,模型在 15 万个候选里给 <tool_call> 的概率一直在 10⁻⁴ 左右。
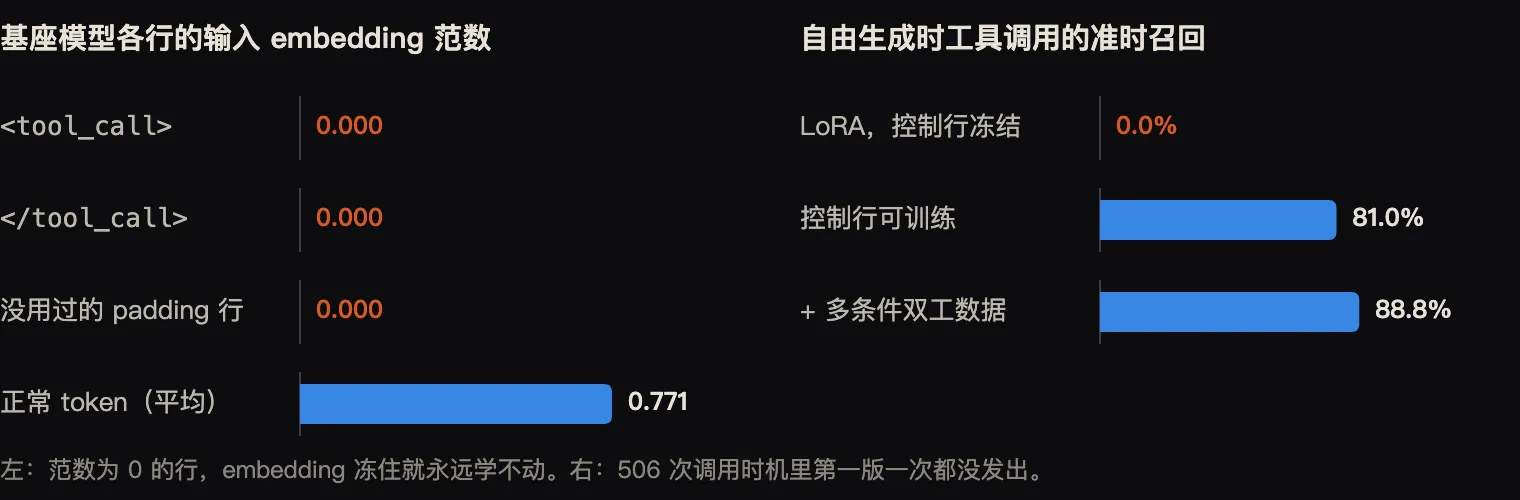
修法:把这两个 token 也升级成可训练的控制行(重新用正态分布初始化),loss 权重设为 5.0。同时改成全参数训练(AuT 冻结,FSDP,fp32 master 权重),加上 0.4 s 的文本提前和按进度的余弦学习率。500 步之内 teacher-forced 调用概率就升到了 0.77;最终模型在留出会话上准时召回 88.8%,1 秒内召回 98.8%,每个会话平均误调用 0.15 次,流式 ASR 的 WER 保持在 2.0%。
两条教训:
- 任何新加的、或者「看起来词表里有」的特殊 token,先查一下它的 embedding 范数。
- **teacher-forced loss 不能代表自由生成时会不会发出某个 token。**一定要做自由生成评测。
让它开口:解耦的 Talker
Thinker 只输出文字,还需要把文字变成声音。
我们没有训练端到端的声学编解码器,原因是合成数据只用了 7 个预设音色、存成 16 kHz,端到端训练只会让解码器记住这 7 个声音。做法是解耦:
- 冻结训练好的 Thinker;
- 复用 MiniCPM-o 4.5 的 TTS 解码器(20 层 Llama,768 维),让它预测 25 Hz 的 S3 语音 code;
- 再用冻结的
token2wav,配合任意一段参考音频,合成 24 kHz 波形。音色完全由参考音频决定,训练不会改变它。
按词尾切,不按秒切
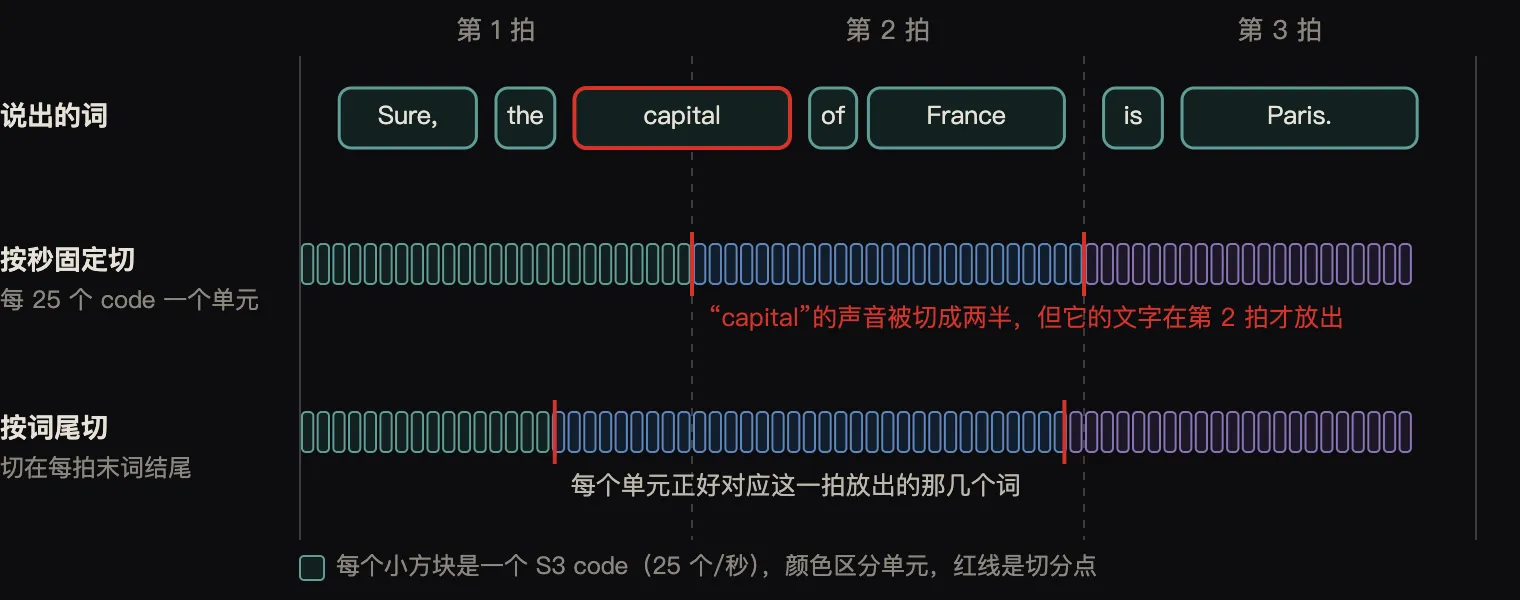
因为文字是按「词说完的那一拍」放出的,如果 S3 code 也按每秒固定 25 个去切,跨越拍子边界的词,它的声音就会被分到错误的单元里。所以我们按每一拍最后一个词的结束时间来切 S3 code:中间单元平均 25.3 个 code(约 1.01 s),没有空单元。被打断的那一轮,最后一个单元不加结束符,让 Talker 学会「话说一半被掐断」,而不是收出一个完整句尾的语调。
坑四:词尾放出要付延迟
文字要等词说完才放出,Talker 要连续播放不卡顿,就得先缓冲一段。实测中位数要缓冲 1.44 s(p95 2.07 s)。这就是后期把文本提前量 τ_lead 设成 0.4 s 的原因。
不依赖 Thinker 的 Talker
Talker 的条件有两种做法:
- hidden:每个文字 token 的 embedding 加上 Thinker 最后一层隐状态的投影(L2 归一化);
- user_audio:只用文字 embedding,前面接用户最近 8 秒的 AuT 表示作为韵律前缀,完全不需要跑 7B 的 Thinker。
在 430 条用没见过的参考音色合成的验证样本上,两者几乎一样:UTMOS 都是 4.27(真值 S3 code 的上限是 4.20),说话人相似度 0.940 vs 0.937,英文 WER 5.3% vs 5.9%(差异在 bootstrap 置信区间内)。但训练成本从 84 降到 27 个 GPU 时,而且任何共享 Qwen 词表的 Thinker 都能直接驱动它。
怎么评测
几条我觉得重要的原则:
- **全量测,不挑样本。**ASR 和口语问答在全部清单上跑(ASR 22,599 条,问答 4,955 条)。空输出、生成到上限的样本全部计入分母。
- **流式就按流式测。**ASR 一秒一秒地喂、不加尾部静音;问答在问题后最多加 60 秒静音,以
<|turn_eos|>停止。 - **话轮行为用 Full-Duplex-Bench v1.0 和 v1.5。**v1.0 测停顿、附和、接话、打断,v1.5 测附和、旁人说话、背景人声这些干扰。比较不同模型的话轮决策时,我们用统一的「文本时间轴」把文字换算成时间,排除各家 TTS 的差异。
- 工具调用用自由生成召回率,同时统计准时(同一拍)和 1 秒内两个口径,以及误调用次数。
还没解决的问题
- **真人麦克风。**训练数据里的用户音轨全部是合成或重新配音的,模型唯一听过的真实录音是朗读的 ASR 语料。用笔记本麦克风实测三段对话,表现很差:一段完全没有回应,ASR 模式 CER 0.62;真实录音里接近静音的间隙,要人为混进一点底噪,模型才会把它当成「用户说完了」。
- **工具调用的延迟。**一段几十个 token 的 JSON 串行解码,可能超过 1 秒的预算。投机解码是一个方向。
- 打断响应率下降,见上文的取舍。
- 每一步修复都同时改了好几个因素(数据、训练方式、控制行、文本提前),所以上面的数字都是「之前 / 之后」的对比,不是严格的单因素消融。比如工具调用能修好,到底是可训练行的功劳还是全参数训练的功劳,没有拆开测过。
清单:如果你也要做一遍
- 先用离线格式只训投影层,把耳朵接上,再上 LoRA,最后才切流式。
- 一定要有单独的流式阶段。离线训好的模型直接按块解码会彻底崩掉。
- 用一个
<|chunk_eos|>同时表示「在听」和「这一拍结束」就够了。 - 双工数据里必须有句中停顿、用户附和、旁人说话、背景人声,否则模型学到的只是声音检测。
- 训双工时一直混着 ASR 和问答数据,防止识别能力退化。
- 新增的特殊 token 先查 embedding 范数;必要时做成可训练的控制行并加大 loss 权重。
- 多卡训练时,loss 按全局有效 token 数归一化。
- 用自由生成评测,别只看 teacher-forced loss。
- 尽早用真麦克风、真环境测一次。